Durante mucho tiempo, gran parte de las conversaciones sobre RAG han girado alrededor del prompt: si usar más contexto, menos contexto, un system prompt más estricto, una temperatura distinta, o un modelo más potente.
Yo también pasé por ahí.
Pero cuando intentas llevar un RAG a un entorno enterprise de verdad, te das cuenta de algo incómodo: la mayoría de problemas importantes no se arreglan con prompt engineering. Se arreglan con arquitectura, disciplina operativa y decisiones de plataforma.
Ese fue el motivo por el que construí RAG Azure Builder: una extensión integrada en el catálogo comunitario de Spec Kit para guiar, de forma estructurada, el onboarding y la operación de un stack RAG en Azure.
No quería construir "otro chatbot con PDFs". Quería construir una base técnica que aguante escenarios reales.
Por qué el prompt deja de ser el centro
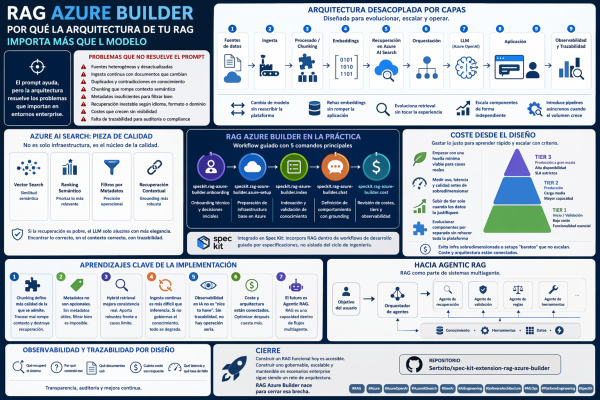
Cuando un RAG sale del laboratorio, aparecen problemas que no estaban en la demo:
- Fuentes heterogéneas y desactualizadas
- Ingesta continua con documentos que cambian
- Duplicados y contradicciones en conocimiento
- Estrategias de chunking que rompen contexto semántico
- Metadatos insuficientes para filtrar bien
- Recuperación inestable según idioma, formato o dominio
- Costes que crecen sin visibilidad
- Falta de trazabilidad para auditoría o compliance
En ese contexto, optimizar el prompt ayuda, sí, pero no corrige una cadena de conocimiento mal diseñada.
La arquitectura que propuse
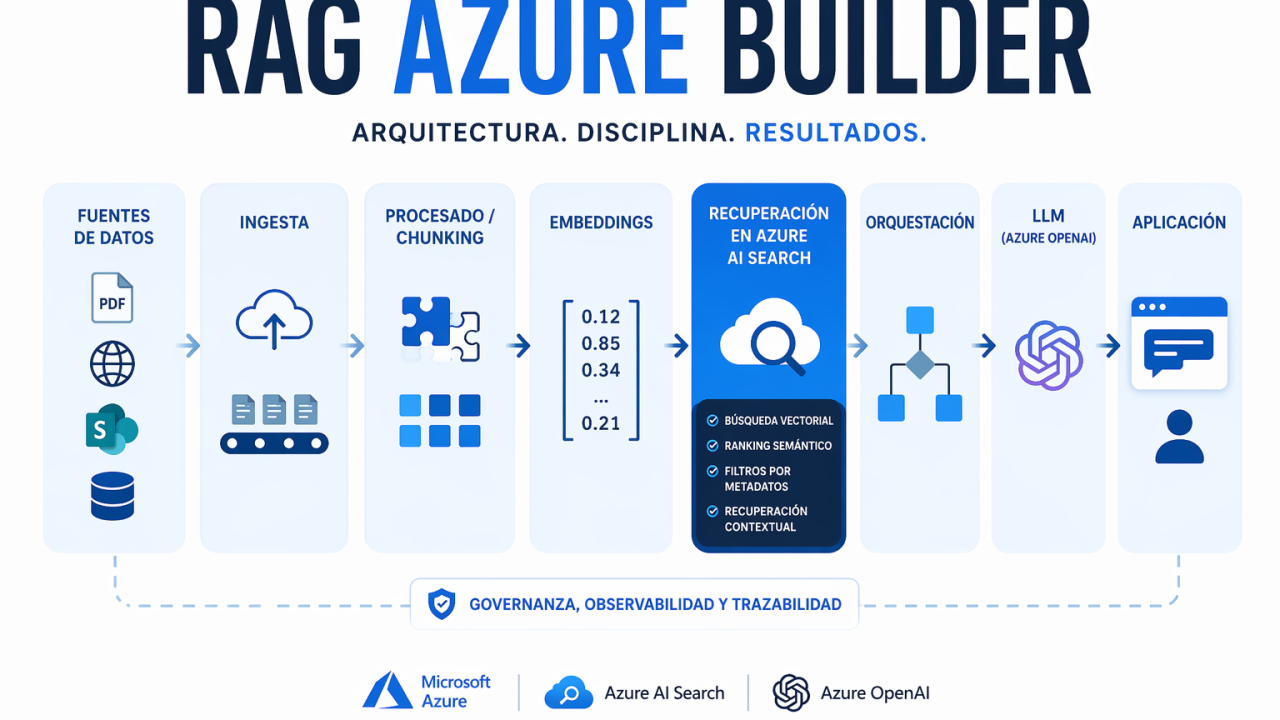
Uno de mis objetivos fue evitar una solución acoplada al modelo o a una sola estrategia de búsqueda. La separación por capas fue deliberada:
Fuentes de datos → Ingesta → Procesado/Chunking → Embeddings → Recuperación en Azure AI Search → Orquestación → LLM → Aplicación
Esta separación no es estética. Es una decisión de supervivencia técnica:
- Puedes cambiar de modelo sin reescribir toda la plataforma.
- Puedes rehacer embeddings sin romper la lógica de aplicación.
- Puedes evolucionar retrieval sin tocar la capa de experiencia.
- Puedes escalar componentes de forma independiente.
- Puedes introducir pipelines asíncronos cuando crece el volumen.
Cuando el sistema crece, el desacoplo deja de ser "buen diseño" y se convierte en requisito operativo.
Azure AI Search como pieza de calidad, no solo de infraestructura
Una de las conclusiones más claras del proyecto: en RAG moderno, retrieval manda.
Si la recuperación es pobre, el LLM solo alucina con más elegancia.
Por eso trabajé el stack para aprovechar enfoques híbridos:
- Vector search para similitud semántica
- Ranking semántico para priorización contextual
- Filtros por metadatos para precisión operacional
- Recuperación contextual para grounding más robusto
Esto cambia radicalmente la estabilidad de las respuestas. No es solo "encontrar algo parecido", es encontrar lo correcto, en el contexto correcto, con trazabilidad suficiente para justificar la respuesta.
Qué aporta RAG Azure Builder en la práctica
Mi extensión no está pensada como un set suelto de scripts, sino como un workflow guiado con cinco comandos principales:
- speckit.rag-azure-builder.onboarding
- speckit.rag-azure-builder.azure-setup
- speckit.rag-azure-builder.index
- speckit.rag-azure-builder.chat
- speckit.rag-azure-builder.cost
Este flujo cubre un camino completo:
- Onboarding técnico y de decisiones iniciales
- Preparación de infraestructura base en Azure
- Indexación y validación de conocimiento
- Definición de comportamiento conversacional con grounding
- Revisión de costes, tiers y observabilidad
Además, al estar integrada en Spec Kit, se puede incorporar dentro de workflows más amplios de desarrollo guiado por especificaciones, en lugar de funcionar aislada del ciclo de ingeniería.
Coste desde el diseño, no como parche al final
Uno de los objetivos del proyecto fue montar una base técnicamente sólida pero económicamente sensata para arrancar. La arquitectura está pensada para empezar con una configuración ajustada de costes y, a partir de ahí, escalar por tiers según volumen, criticidad y SLAs.
Eso significa:
- Empezar con una huella mínima viable para validar casos reales.
- Medir uso, latencia y calidad de recuperación antes de sobredimensionar.
- Subir de tier solo cuando los datos operativos lo justifiquen.
- Evolucionar componentes por separado sin rehacer toda la plataforma.
Este enfoque evita dos errores típicos: infra sobredimensionada demasiado pronto o setups "baratos" que luego no escalan. La idea es simple: gastar lo justo para aprender rápido, y escalar con criterio cuando el producto lo pida.
Aprendizajes técnicos derivados de la implementación
Más allá del marco conceptual, estas son conclusiones obtenidas durante la construcción y operación del sistema.
1. El chunking define más calidad de la que la gente admite Si troceas mal, rompes unidades semánticas y destruyes recuperación. Un chunking "rápido" suele convertirse en deuda técnica de contexto.
2. Los metadatos no son opcionales Sin metadatos útiles, filtrar bien es imposible. Y sin filtrado bueno, la relevancia cae incluso con embeddings de alta calidad.
3. Hybrid retrieval mejora consistencia real La combinación de estrategias de búsqueda aporta robustez frente a casos límite. No es una moda, es resiliencia operativa.
4. Ingesta continua es más difícil que inferencia La inferencia es visible y "bonita"; la ingesta es silenciosa y crítica. Si no gobiernas bien el conocimiento que entra, todo lo demás se degrada.
5. Observabilidad en IA no es "nice to have" En producción necesitas responder preguntas incómodas:
- Qué recuperó el sistema
- Por qué contestó eso
- Qué documentos usó
- Cuánto costó esa respuesta
- Qué latencia y qué tasa de fallo hubo
Sin eso, no hay operación seria. Hay magia negra.
6. Coste y arquitectura están conectados Si no diseñas con coste en mente, escalar se convierte en problema financiero, no técnico. Optimizar después suele ser más caro que diseñar bien desde el inicio.
7. El futuro es Agentic RAG Cada vez veremos más sistemas donde recuperar contexto es solo una capacidad dentro de un flujo multiagente más amplio:
- agentes que validan evidencia
- agentes que aplican reglas
- agentes que deciden herramientas
- agentes que coordinan pasos según objetivo y contexto
RAG deja de ser un producto aislado y pasa a ser parte de una arquitectura de decisión.
Qué intento enseñar con este proyecto
Si tuviera que resumirlo en una idea:
No estoy intentando enseñar a "hacer un chatbot". Estoy enseñando a construir una plataforma de conocimiento confiable sobre Azure.
Eso implica:
- Diseñar para evolución, no para demo
- Pensar en operación desde el día uno
- Tratar retrieval como núcleo de calidad
- Hacer trazable cada decisión relevante
- Asumir que escalar cambia las reglas del juego
Cierre
Construir un RAG funcional hoy es relativamente accesible. Construir uno gobernable, escalable y mantenible en escenarios enterprise sigue siendo un reto de arquitectura.
RAG Azure Builder nace exactamente para cerrar esa brecha.
Si estás trabajando en IA aplicada en Azure, me interesa intercambiar experiencias reales sobre retrieval, observabilidad, costes y operación en producción.
Si quieres, el próximo artículo lo hago con un caso end to end: desde fuentes documentales reales hasta evaluación de calidad de recuperación y runbook operativo.
Repositorio: Sertxito/spec-kit-extension-rag-azure-builder
#RAGAzureBuilder #RAG #Azure #AzureOpenAI #AzureAISearch #GenAI #AIEngineering #SoftwareArchitecture #MLOps #PlatformEngineering #SpecKit
Rag Azure Builder