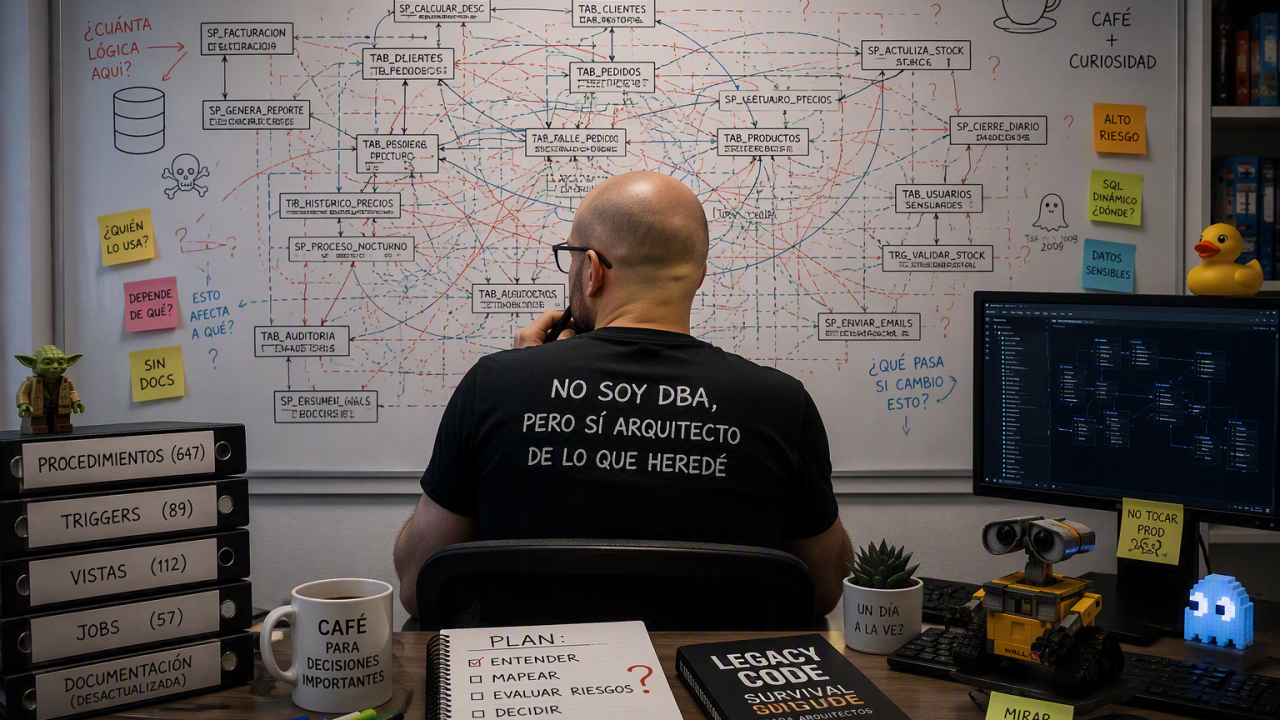
Hace un par de años me encontré con una situación que probablemente muchos arquitectos, desarrolladores y responsables técnicos reconocerán: una base de datos SQL Server legacy era el corazón operativo de varios sistemas en producción. Miles de transacciones diarias, procedimientos almacenados acumulados durante años, lógica de negocio crítica repartida entre múltiples objetos y una sensación constante de que nadie tenía una visión completa de lo que realmente estaba ocurriendo.
La base de datos no estaba rota. De hecho, funcionaba. Y precisamente por eso el problema era más delicado. Cada cambio pequeño abría la misma pregunta: ¿sabemos realmente qué estamos tocando y qué puede romperse alrededor? Había documentación, pero no siempre era fiable. Había conocimiento, pero vivía en conversaciones, hojas de cálculo, reuniones y personas concretas. Y había experiencia, mucha experiencia, pero no era fácil reutilizarla cuando entraba otra persona, cambiaba el equipo o aparecía una nueva iniciativa.
La primera decisión fue intentar entender antes de tocar. Pero al hacerlo apareció el verdadero cuello de botella: el análisis manual de una base de datos legacy crítica no escala. Inventariar objetos lleva tiempo, reconstruir dependencias requiere contexto, revisar riesgos exige criterio y mantener documentación actualizada se vuelve casi imposible si el sistema sigue cambiando. En ese momento entendí que el problema no era SQL Server. El problema era la gobernanza del conocimiento que se había acumulado alrededor de SQL Server.
Cuando una base de datos deja de ser sólo una base de datos
En muchos sistemas enterprise, la base de datos empieza como un almacén de información y con los años acaba convirtiéndose en una parte fundamental del software. La lógica de negocio se desplaza a Stored Procedures, aparecen triggers que modifican datos de forma indirecta, los jobs nocturnos sostienen procesos críticos y las vistas esconden capas de abstracción que nadie quiere tocar sin revisar tres veces antes.
Ese patrón no suele nacer de una mala decisión aislada. Nace de años de urgencias, entregas, cambios funcionales, integraciones, parches y decisiones que probablemente tuvieron sentido en su momento. El problema es que, sin una visión centralizada, cada ajuste deja una pequeña capa de complejidad. Y después de diez o quince años, lo que tienes delante ya no es simplemente una base de datos antigua. Es una red de decisiones históricas cristalizadas en código.
Por eso cambiar una línea puede ser técnicamente sencillo y, al mismo tiempo, operativamente arriesgado. El reto no es hacer el cambio. El reto es saber qué implica el cambio. Qué objeto depende de qué otro, qué proceso se ejecuta por la noche, qué lógica se duplicó en otro procedimiento, qué acceso sensible no está auditado o qué parte del sistema nadie ha documentado porque siempre ha funcionado.
Por qué el análisis manual deja de escalar
La respuesta habitual ante este tipo de escenarios suele ser generar documentación. Inventariar objetos, revisar procedimientos, analizar dependencias, producir informes y sentarse en varias sesiones para reconstruir contexto. Todo eso ayuda, pero tiene un límite claro: cuanto más grande es el sistema, más rápido crece el esfuerzo necesario para entenderlo. Y mientras documentas, el sistema sigue evolucionando.
Además, los riesgos importantes rara vez aparecen perfectamente ordenados. El SQL dinámico sin parametrizar puede vivir escondido en procedimientos que nadie revisa. Un objeto crítico puede no tener documentación. Una cadena de dependencias puede cruzar varias capas sin aparecer en ningún diagrama. Un job puede ser esencial para negocio aunque nadie lo tenga en el radar de monitorización. Detectar un patrón una vez es útil; detectarlo de forma consistente, repetible y trazable es otra cosa.
Ahí fue donde la pregunta cambió. Ya no se trataba de hacer un informe más completo. Se trataba de crear una forma de capturar conocimiento operativo, convertirlo en criterios reutilizables y reducir incertidumbre antes de tomar decisiones. La documentación tenía que dejar de ser una fotografía manual para convertirse en un subproducto de un proceso más gobernado.
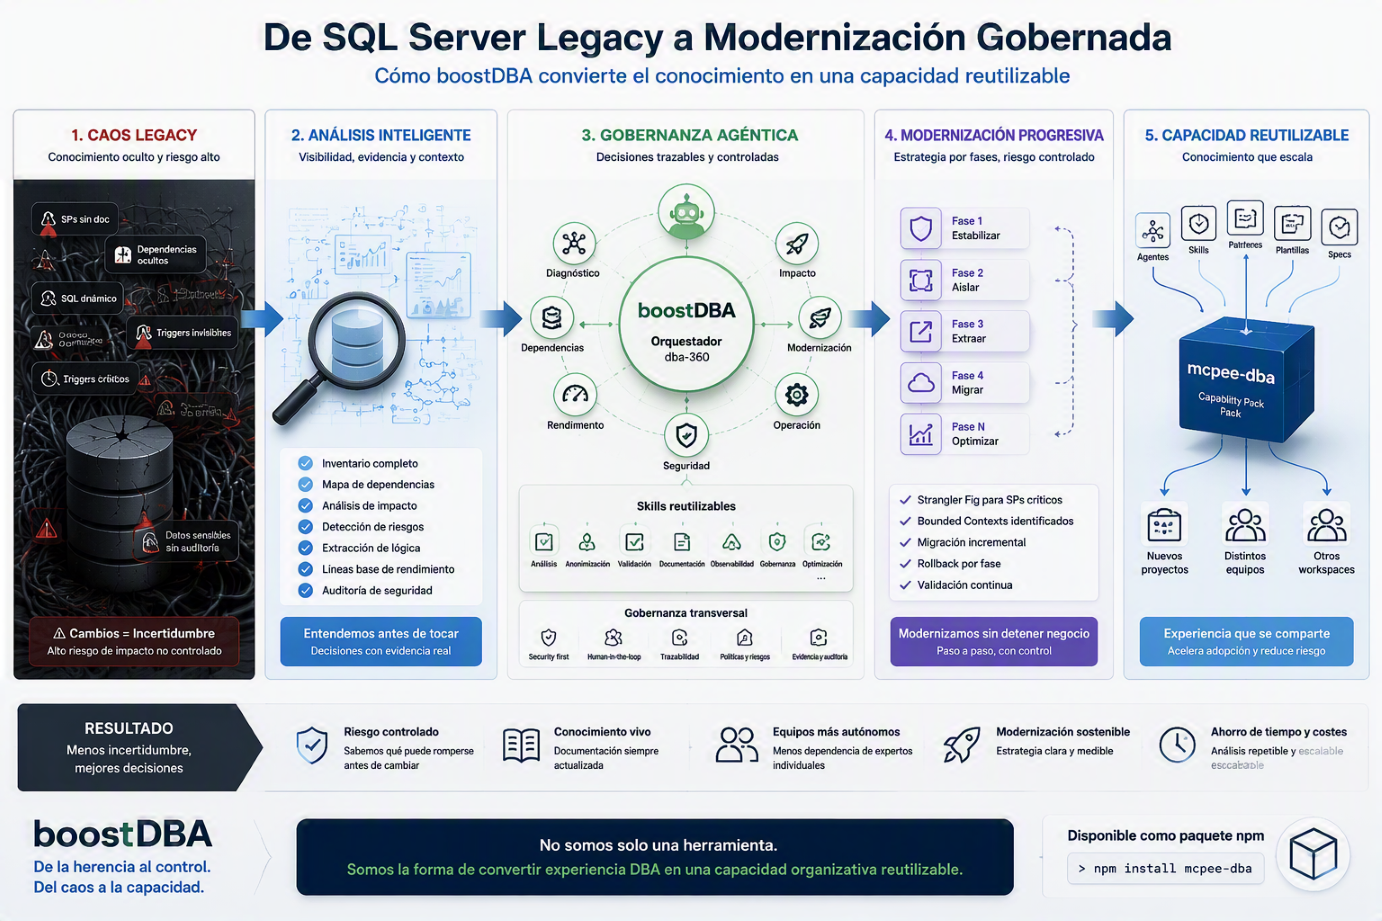
De SQL Server Legacy a Modernización Gobernada
Cómo terminó apareciendo boostDBA
boostDBA empezó como una necesidad práctica: entender mejor bases de datos SQL Server legacy antes de intervenir sobre ellas. Pero poco a poco dejó de tener sentido verlo como una herramienta puntual. El problema se repetía, los patrones se repetían y las preguntas importantes también se repetían. ¿Qué depende de esto? ¿Qué pasa si lo cambio? ¿Qué riesgo tiene? ¿Qué debería modernizar primero? ¿Qué necesita aprobación humana? ¿Qué evidencia sostiene esta recomendación?
La solución evolucionó hacia una plataforma de conocimiento operativo. En lugar de un único análisis genérico, boostDBA se apoyó en agentes especializados, skills reutilizables, patrones, plantillas, especificaciones y criterios de gobernanza. La idea no era meter complejidad porque sí, sino separar responsabilidades. Un agente que intenta analizarlo todo acaba siendo frágil. Un conjunto de capacidades con fronteras claras permite mayor precisión, mejor mantenimiento y más trazabilidad.
El cambio importante fue pasar de preguntar “qué contiene esta base de datos” a preguntar “qué necesito saber para decidir con menos riesgo”. Ese matiz cambia completamente el enfoque. Una organización no necesita más ruido. Necesita señales claras, priorizadas y explicables para poder actuar con confianza.
Tratar la IA como ingeniería y no como magia
Uno de los aprendizajes más importantes fue tratar los agentes como componentes gobernados, no como prompts sueltos. En entornos críticos no basta con que un modelo genere una respuesta convincente. Necesitas contratos, restricciones, validación y trazabilidad. Necesitas saber qué entra, qué sale, qué nivel de profundidad se espera, para quién se está generando la salida y qué advertencias quedan abiertas.
Por eso boostDBA trabaja con contratos de entrada y salida. Conceptos como el rol objetivo, la anonimización, la criticidad, la completitud o los warnings no son detalles decorativos. Son la diferencia entre una respuesta generada y una salida que puede revisarse, auditarse y reutilizarse. Sin contrato, un modelo produce texto. Con contrato, un sistema puede producir resultados más consistentes.
Esta es una de las ideas que más me interesa de toda la experiencia: la calidad técnica no depende sólo del modelo. Depende del diseño del sistema que rodea al modelo. Seguridad, evidencia, observabilidad, revisión humana y gobierno del proceso importan tanto como la capacidad generativa. Especialmente cuando el coste de equivocarse puede acabar en producción.
Lo que descubrimos al analizar sistemas reales
Al aplicar este enfoque sobre sistemas reales aparecieron hallazgos que explicaban por qué el análisis manual no era suficiente. Se identificaron miles de procedimientos almacenados inventariados, casos de SQL dinámico sin parametrizar, objetos críticos sin documentación, dependencias sensibles alrededor de procesos criptográficos, brechas en alta disponibilidad, jobs críticos con monitorización insuficiente y áreas donde la modernización podía plantearse de forma progresiva.
Lo más interesante no fue encontrar problemas técnicos aislados. Lo interesante fue ver patrones. Conocimiento concentrado en muy pocos puntos. Lógica de negocio difícil de explicar. Riesgo operativo distribuido en capas. Documentación que no reflejaba el estado real. Dependencias que sólo aparecían al analizar el sistema de forma sistemática. Y oportunidades de modernización que no exigían reescribir todo, sino ordenar el camino por fases.
Ahí se confirmó una tesis importante: modernizar una base de datos legacy no empieza migrando tecnología. Empieza recuperando visibilidad. Si no entiendes qué hace el sistema, qué dependencias tiene y qué riesgos concentra, cualquier modernización puede convertirse en una apuesta. La estrategia correcta no siempre es un big bang. Muchas veces es entender, estabilizar, aislar y extraer progresivamente.
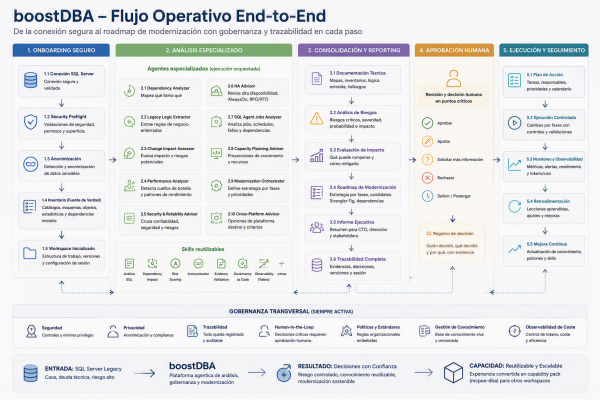
Flujo Operativo End-to-End
Lo que me llevo como arquitecto
La primera lección es que las bases de datos legacy rara vez son sólo un problema técnico. Son acumulación de decisiones. Decisiones urgentes, decisiones correctas en su contexto, decisiones no documentadas y decisiones que nadie volvió a revisar. Llamarlo deuda técnica es útil, pero a veces se queda corto. Muchas veces es gobernanza improvisada cristalizada en código.
La segunda lección es que no todo se arregla reescribiendo. Reescribir sin entender puede sustituir deuda conocida por deuda nueva. Antes de modernizar hay que capturar conocimiento, mapear riesgos, ordenar dependencias y decidir qué merece ser extraído, qué debe estabilizarse y qué puede esperar. La modernización real necesita una estrategia, no sólo energía.
La tercera lección es que la intervención humana sigue siendo parte del diseño. Automatizar análisis rutinarios tiene mucho sentido, pero las decisiones de alto impacto deben elevarse, revisarse y quedar trazadas. En sistemas críticos, madurez no significa automatizarlo todo. Significa saber qué automatizar, qué validar y qué dejar bajo aprobación humana.
La cuarta lección es que el conocimiento operativo debería tratarse como un activo. Si vive sólo en personas, conversaciones o documentos sueltos, la organización seguirá dependiendo de memoria individual. Si se captura, se estructura, se versiona y se reutiliza, empieza a convertirse en capacidad organizativa.
Conclusión
Hoy veo boostDBA menos como una herramienta para SQL Server y más como una respuesta a una pregunta de arquitectura: ¿cómo codificamos la gobernanza en el lugar donde realmente vive parte del software? En muchos sistemas legacy, el problema no es que la base de datos exista. El problema es que nadie gobierna de forma consistente el conocimiento acumulado dentro de ella.
Las organizaciones no suelen sufrir sólo porque tengan bases de datos legacy. Sufren porque el conocimiento sobre esas bases de datos está repartido entre código, documentación, conversaciones y personas. Mientras ese conocimiento permanezca fragmentado, cada cambio seguirá generando incertidumbre.
Para mí, boostDBA nace precisamente de ahí: de la necesidad de capturar experiencia, convertirla en criterios reutilizables y ayudar a que otros equipos puedan entender, estabilizar y modernizar sin empezar desde cero. Porque cuando el conocimiento deja de vivir únicamente en personas concretas y pasa a formar parte de un sistema gobernado, versionado y reutilizable, deja de ser experiencia individual. Se convierte en capacidad organizativa.
El repositorio sigue siendo el lugar natural para evolucionar, revisar y contribuir, pero el paquete facilita el consumo de la capacidad. Aquí os dejo los dos 🙃😊.
Repositorio: boostDBA
Paquete npm: mcpee-dba