Este proyecto no empezó como una plataforma ambiciosa de agentes. Empezó de una forma mucho más sencilla: como una necesidad personal.
Quería construir un RAG Builder que me ayudase en mi día a día: preparar contexto, recuperar información útil, acelerar análisis, reducir fricción y apoyarme en tareas donde repetir siempre el mismo proceso no tenía demasiado sentido.
Pero como suele pasar con la tecnología cuando la llevas a un uso real, la herramienta empezó a enseñarme sus límites. No en una demo. No en una presentación. En el uso diario.
Y entonces llegó el cambio de paradigma en la facturación, el consumo empezó a importar de otra manera y este mes me encontré con una realidad bastante clara: tenía limitaciones y tenía que poner remedio. No por sofisticar por sofisticar. Por sentido común.
Ahí es donde el RAG Builder dejó de ser solo una herramienta y empezó a evolucionar hacia una plataforma más operable, más consciente del coste y más preparada para crecer.
Cuando el coste te obliga a pensar mejor
Durante mucho tiempo, cuando hablábamos de RAG o de agentes, el foco estaba en conseguir mejores respuestas: más contexto, mejores prompts, mejores modelos, más recuperación, más capacidades.
Pero cuando empiezas a usarlo de verdad, aparece otra pregunta igual o más importante: ¿cuánto cuesta cada decisión?, ¿cuánto contexto estamos consultando sin necesidad?, ¿cuántas veces repetimos descubrimientos?, ¿cuándo merece la pena invocar un motor más potente y cuándo no?
La respuesta no era simplemente “optimizar tokens”. Era diseñar una arquitectura con criterio.
Porque un sistema puede responder bien y, aun así, ser poco sostenible. Puede parecer inteligente y, aun así, no saber explicar por qué tomó una ruta. Puede resolver una tarea y, aun así, estar gastando más de lo necesario.
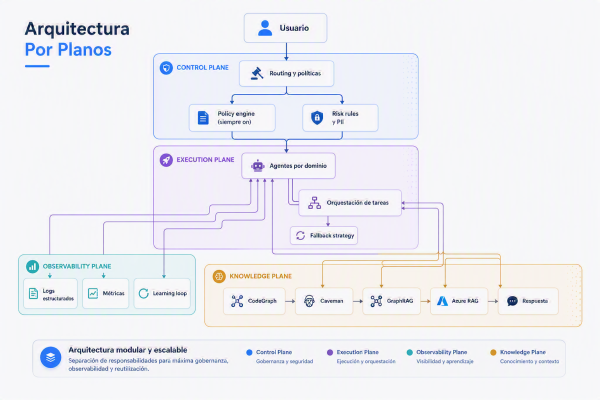
Arquitectura por planos. Control Plane - Execution Plane - Observability Plane - Knowledge Plane
Del RAG Builder a una plataforma operable
Ese fue el salto natural: pasar de un RAG Builder centrado en ayudarme a recuperar y construir contexto, a una plataforma capaz de operar decisiones.
Para mí, una plataforma de este tipo no debería limitarse a generar una respuesta. Debería poder decidir qué motor usar, cuándo reutilizar memoria, cuándo ampliar recuperación, cuándo pedir intervención humana, cuándo hacer fallback y cómo dejar rastro de todo lo que ha pasado.
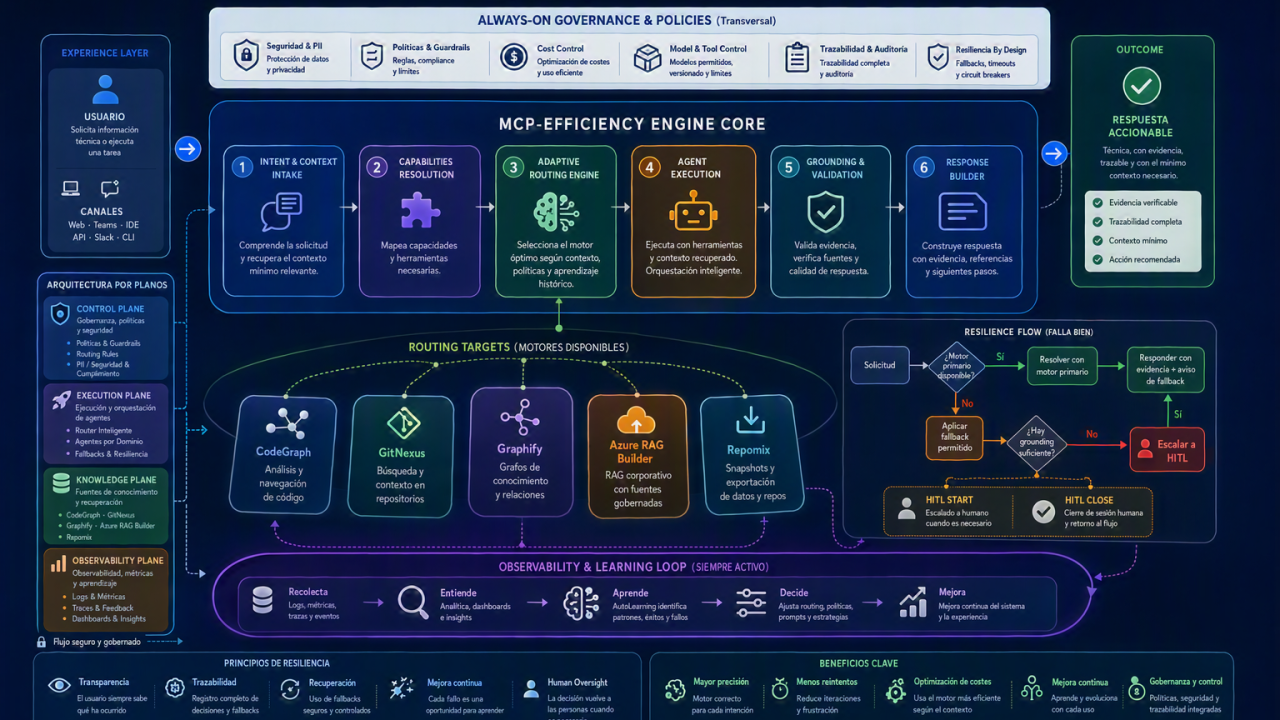
Ahí entran las piezas que han ido dando forma a esta evolución: routing por dominio, estrategia memory-first, observabilidad, control de coste, fallback trazado, HITL, contratos de capacidad y un Learning Loop que permita mejorar sin perder gobierno.
Visión general de la plataforma. Punto de entrada visual para entender la operabilidad de la plataforma.
Routing: elegir bien antes de ejecutar
El routing fue una de las primeras piezas que tuve claro que necesitaba reforzar. Si cada petición entra al sistema y acaba usando el mismo camino por defecto, el coste se dispara y la arquitectura deja de tener criterio.
La idea es sencilla: antes de ejecutar, hay que elegir bien. Detectar intención, identificar dominio, seleccionar motor, aplicar reglas, conocer límites y dejar trazabilidad de la decisión.
No se trata de complicar el sistema, sino de evitar que todo se resuelva con fuerza bruta. Porque si todo acaba pasando por el motor más caro, la plataforma no está optimizando: está delegando la decisión.
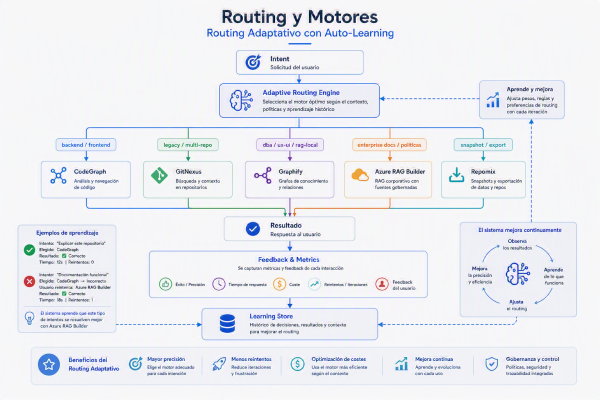
Routing. Apoya la idea de elegir bien antes de ejecutar y de no enviar todas las peticiones por el mismo camino.
Memory-first: no pagar dos veces por el mismo descubrimiento
Otra lección bastante clara fue que no tenía sentido pagar dos veces por el mismo descubrimiento. Si algo ya se había analizado, validado o aprendido, la plataforma debía poder reutilizarlo con criterio.
Memory-first no significa guardar todo ni confiar ciegamente en cualquier recuerdo. Significa consultar primero el conocimiento operativo útil antes de volver a lanzar retrieval, siempre con reglas de vigencia, validación y trazabilidad.
Esto reduce coste, baja latencia y, sobre todo, da continuidad al sistema. Deja de comportarse como si cada interacción empezase desde cero.
HITL: intervención humana proporcional al riesgo
En paralelo, necesitaba asumir algo importante: no todas las decisiones deben automatizarse igual. Hay tareas de bajo impacto que pueden fluir solas, y hay decisiones donde tiene todo el sentido que una persona valide antes de avanzar.
Por eso el enfoque HITL no lo veo como un freno, sino como una escala de responsabilidad. Cuanto mayor sea el riesgo, mayor debe ser el nivel de validación humana.
La clave es no meter humanos en todos los pasos, sino ponerlos donde aportan gobierno, criterio y seguridad.
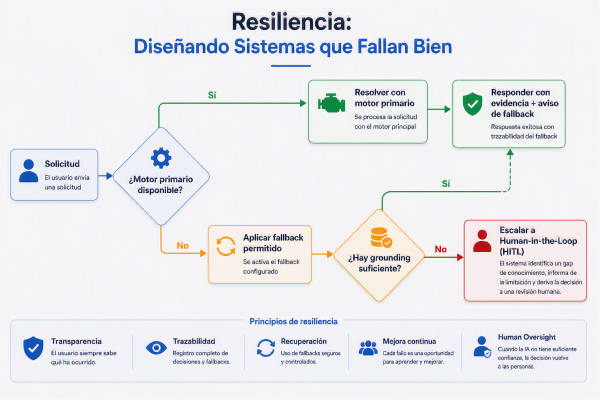
HITL. Aterriza la intervención humana como una escala proporcional al riesgo y no como un freno al sistema.
Learning Loop: aprender sin perder gobierno
La siguiente evolución natural fue cerrar el ciclo. Si el sistema decide una ruta, ejecuta una acción, recibe feedback y obtiene un resultado, esa experiencia debería servir para mejorar futuras decisiones.
Ese Learning Loop no va de que la plataforma aprenda de forma opaca. Va de registrar señales: qué routing funcionó, qué fallback hizo falta, qué corrección humana apareció, qué motor fue suficiente y dónde el sistema necesitó más contexto.
Pero ese aprendizaje tiene que ser gobernado. Si no es trazable, revisable y reversible, no es mejora continua: es deuda operativa acumulándose con buena apariencia.
Observabilidad: si no puedes explicarlo, no lo puedes operar
Todo lo anterior solo tiene sentido si se puede observar. Y no hablo solo de logs técnicos, sino de observabilidad de decisión.
Para operar una plataforma de agentes necesito saber qué intención se detectó, qué dominio aplicaba, qué motor se eligió, cuánto costó, cuánto tardó, qué evidencia se usó, si hubo fallback, si intervino una persona y cuál fue el resultado.
Sin eso, la mejora continua se convierte en intuición. Y la intuición puede valer para explorar, pero no para operar sistemas que tienen coste, riesgo y responsabilidad.
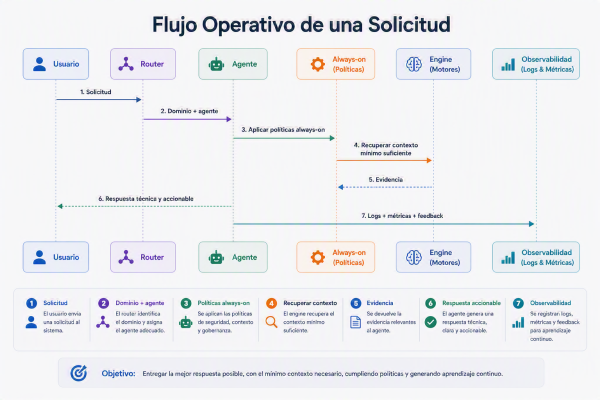
Observabilidad y trazabilidad. Cierra la parte operativa mostrando por qué una plataforma de agentes necesita poder explicar lo que ha ocurrido.
Versión 0.1.10: una plataforma viva
Ahora mismo lo veo como una plataforma viva. No está terminada, y precisamente por eso me gusta. Vamos por la versión 0.1.10, y cada iteración me ayuda a entender mejor qué necesita realmente una arquitectura de agentes para ser útil en el día a día.
Mi prueba de madurez sigue siendo sencilla: ¿puedo reconstruir en pocos minutos la ruta completa de una solicitud real?
Intención, dominio, motor elegido, memoria reutilizada, evidencia consultada, coste, latencia, fallback, validación humana, feedback y resultado.
Si puedo hacerlo, la plataforma no solo responde: se puede operar, auditar y mejorar.
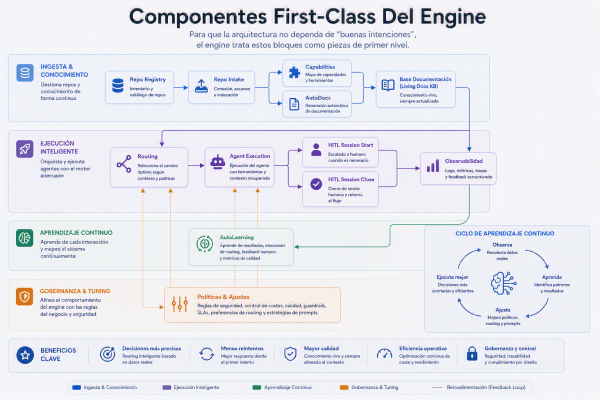
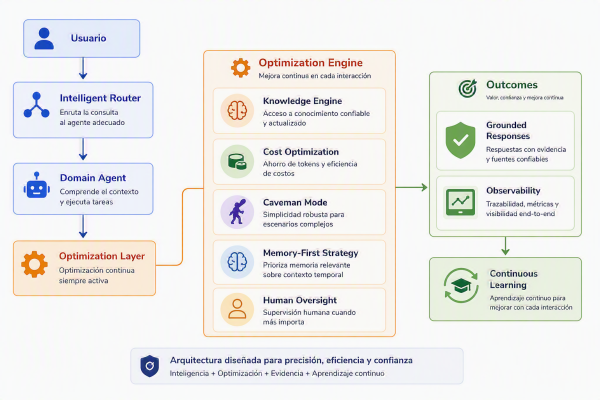
Componentes First-Class del Engine. Para que la arquitectura no dependa de "buenas intenciones", el engine trata estos bloques como piezas de primer nivel.
Cierre
Y siendo completamente honesto, esto lo creé primero para mí. Para mi día a día. Para rascar tiempo y tokens donde lo estaba perdiendo, para tomar mejores decisiones técnicas y para no depender siempre de procesos manuales repetidos.
Pero también creo que una de las partes más bonitas de construir tecnología es compartirla. Enseñar lo que funciona, enseñar lo que todavía está en construcción y abrir la puerta a que otras personas la cuestionen, la prueben, la rompan y la mejoren.
Así que os dejo el enlace al repo por si queréis verlo, usarlo, proponer cambios o evolucionarlo conmigo. Porque si la tecnología es una plataforma viva, tiene todo el sentido que también crezca en comunidad.
https://github.com/Sertxito/mcp-efficiency-engine
O si preferís instalarlo y usarlo directamente desde npm:
npm install mcp-efficiency-engine
Aunque recomiendo leer primero la documentación y cualquier duda aquí me tenéis ^.^